
Μια αναλυτική περιήγηση στον κόσμο των νευρωνικών δικτύων, των Transformers και των μαθηματικών μηχανισμών που επιτρέπουν σε μια μηχανή να παράγει γλώσσα, να επιλύει προβλήματα και να συνομιλεί με τον άνθρωπο. Σε συνέχεια του άρθρου “Η είσοδος της Τεχνητής Νοημοσύνης στην εργασία και την καθημερινή μας ζωή”
Εισαγωγή: Τι συμβαίνει όταν μιλάμε με μια μηχανή;
Τα τελευταία χρόνια, η Τεχνητή Νοημοσύνη έχει περάσει από τα ερευνητικά εργαστήρια στην καθημερινότητα εκατομμυρίων ανθρώπων. Εφαρμογές όπως το ChatGPT μπορούν να συντάσσουν κείμενα, να εξηγούν επιστημονικές έννοιες, να γράφουν προγράμματα υπολογιστών και να συμμετέχουν σε σύνθετους διαλόγους.
Πώς όμως είναι δυνατόν μια μηχανή να παράγει απαντήσεις που πολλές φορές μοιάζουν με ανθρώπινη σκέψη;
Αναζητά απλώς πληροφορίες σε μια τεράστια βάση δεδομένων; Έχει απομνημονεύσει εκατομμύρια απαντήσεις; Ή συμβαίνει κάτι πολύ πιο σύνθετο;
Η πραγματικότητα βρίσκεται στον συνδυασμό μαθηματικών, στατιστικής, νευρωνικών δικτύων και τεράστιας υπολογιστικής ισχύος.
Για να κατανοήσουμε πώς λειτουργεί το ChatGPT, πρέπει πρώτα να γνωρίσουμε την τεχνολογία που βρίσκεται στη βάση των σύγχρονων μεγάλων γλωσσικών μοντέλων.
1. Τι είναι ένα Large Language Model;
Το ChatGPT βασίζεται σε μεγάλα μοντέλα Τεχνητής Νοημοσύνης, γνωστά ως Large Language Models (LLMs).
Ένα LLM είναι ένα νευρωνικό μοντέλο που εκπαιδεύεται πάνω σε μεγάλες ποσότητες δεδομένων, ώστε να μάθει μοτίβα, σχέσεις και δομές της γλώσσας.
Η βασική αρχή της εκπαίδευσης ενός αυτοπαλινδρομικού γλωσσικού μοντέλου είναι φαινομενικά απλή: να προβλέπει ποιο τμήμα κειμένου είναι πιθανότερο να ακολουθήσει ένα προηγούμενο.
Αν του δώσουμε την πρόταση:
«Η πρωτεύουσα της Ελλάδας είναι η…»
ένα κατάλληλα εκπαιδευμένο μοντέλο θα αποδώσει υψηλή πιθανότητα στη συνέχεια «Αθήνα».
Όμως, όταν ένα τέτοιο σύστημα εκπαιδεύεται σε τεράστια κλίμακα, αποκτά ικανότητες που υπερβαίνουν την απλή συμπλήρωση προτάσεων.
Μπορεί να επεξεργάζεται συντακτικές και σημασιολογικές σχέσεις, να συνδυάζει πληροφορίες και να εκτελεί ορισμένες μορφές συλλογισμού.
Το κρίσιμο στοιχείο είναι ότι οι πληροφορίες δεν οργανώνονται όπως σε ένα παραδοσιακό λεξικό ή μια σχεσιακή βάση δεδομένων. Αναπαρίστανται κυρίως μέσα από αριθμητικές παραμέτρους και την αλληλεπίδρασή τους.
2. Η αρχιτεκτονική Transformer: Η τεχνολογική επανάσταση του 2017
Το 2017 δημοσιεύτηκε η επιστημονική εργασία «Attention Is All You Need», από τους Ashish Vaswani και συνεργάτες.
Η εργασία παρουσίασε την αρχιτεκτονική Transformer, η οποία άλλαξε ριζικά την έρευνα στην επεξεργασία φυσικής γλώσσας.
Πριν από αυτή την εξέλιξη, πολλά γλωσσικά συστήματα χρησιμοποιούσαν αναδρομικά νευρωνικά δίκτυα, τα οποία επεξεργάζονταν ακολουθίες με ισχυρούς διαδοχικούς περιορισμούς.
Ο Transformer εισήγαγε μια διαφορετική προσέγγιση, αξιοποιώντας μηχανισμούς Attention ώστε να εξετάζει σχέσεις ανάμεσα στις διαφορετικές θέσεις μιας ακολουθίας.
Αυτό επέτρεψε αποτελεσματικότερη παράλληλη εκπαίδευση και καλύτερη διαχείριση πολλών γλωσσικών εξαρτήσεων.
Η οικογένεια GPT προέρχεται από την κατηγορία των αυτοπαλινδρομικών Transformer μοντέλων.
Η γενική διαδρομή επεξεργασίας μπορεί να περιγραφεί ως εξής:
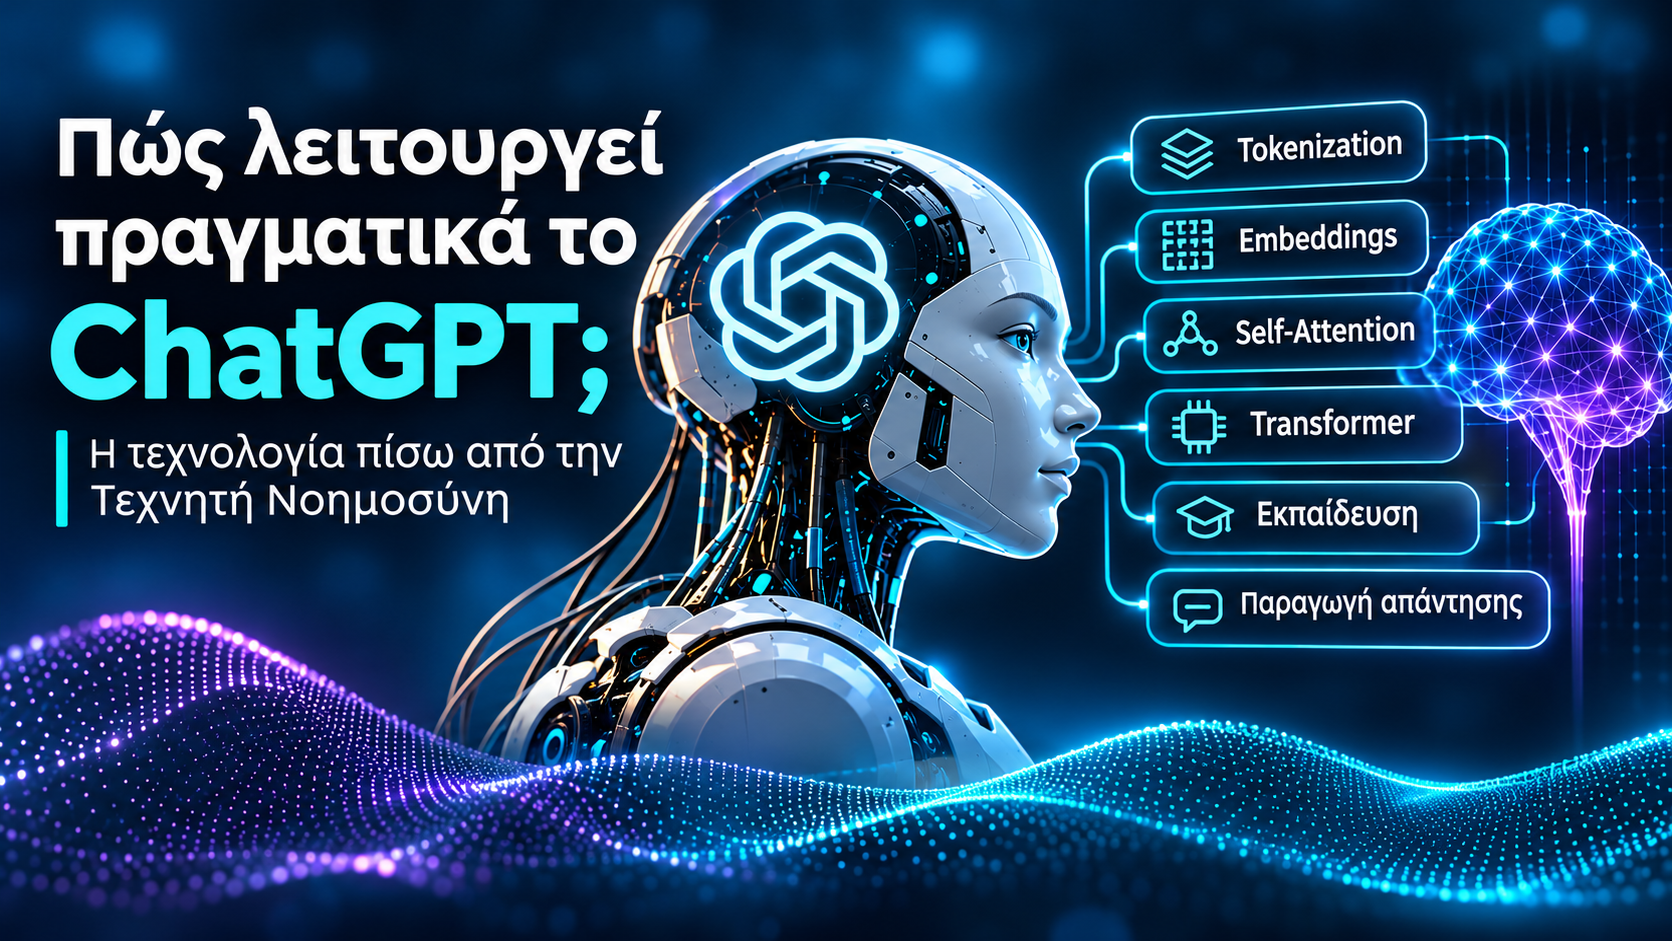
Ερώτηση χρήστη → Tokenization → Embeddings → Transformer → Υπολογισμός πιθανοτήτων → Παραγωγή απάντησης
Κάθε στάδιο περιλαμβάνει συγκεκριμένες μαθηματικές λειτουργίες.
3. Tokenization: Πώς μετατρέπεται η ανθρώπινη γλώσσα σε αριθμούς
Οι υπολογιστές δεν επεξεργάζονται τη γλώσσα με τον τρόπο που την αντιλαμβανόμαστε εμείς.
Ένα γλωσσικό μοντέλο χρησιμοποιεί μια διαδικασία γνωστή ως tokenization.
Το κείμενο χωρίζεται σε μονάδες που ονομάζονται tokens. Ένα token μπορεί να αντιστοιχεί σε ολόκληρη λέξη, μέρος μιας λέξης, σημείο στίξης ή άλλο στοιχείο του κειμένου.
Για παράδειγμα, η λέξη «τεχνητή» μπορεί, ανάλογα με τον tokenizer, να αναπαρασταθεί ως ένα token ή ως περισσότερα μικρότερα τμήματα.
Κάθε token αντιστοιχίζεται σε έναν αριθμητικό αναγνωριστικό κωδικό (token ID).
Έτσι, η ανθρώπινη γλώσσα μετατρέπεται σε μια ακολουθία αριθμών που μπορεί να υποστεί μαθηματική επεξεργασία.
Ωστόσο, οι αριθμοί αυτοί δεν διαθέτουν από μόνοι τους σημασιολογική πληροφορία.
Γι’ αυτό απαιτείται το επόμενο στάδιο.
4. Embeddings: Η γεωμετρία των εννοιών
Οι αριθμητικοί κωδικοί των tokens μετατρέπονται σε διανύσματα πραγματικών αριθμών, τα οποία ονομάζονται embeddings.
Ένα τέτοιο διάνυσμα μπορεί να έχει εκατοντάδες ή χιλιάδες διαστάσεις.
Για παράδειγμα, ένα token θα μπορούσε υποθετικά να αναπαρίσταται από το διάνυσμα:
[0.23, -0.71, 0.56, 0.12, …]
Οι αριθμοί αυτοί μαθαίνονται κατά την εκπαίδευση του μοντέλου.
Δεν σημαίνει ότι η πρώτη διάσταση αντιστοιχεί υποχρεωτικά στο «χρώμα», η δεύτερη στο «μέγεθος» ή η τρίτη σε κάποια συγκεκριμένη ανθρώπινη έννοια.
Οι πληροφορίες μπορούν να αναπαρίστανται κατανεμημένα, μέσα από σύνθετους συνδυασμούς πολλών διαστάσεων.
Επιπλέον, ο Transformer μετασχηματίζει αυτές τις αναπαραστάσεις ανάλογα με το συμφραζόμενο.
Η λέξη «φύλλο», για παράδειγμα, αποκτά διαφορετικό νόημα στις προτάσεις:
«Ένα φύλλο έπεσε από το δέντρο».
«Έγραψα τις σημειώσεις μου σε ένα φύλλο χαρτί».
Η δυνατότητα αξιοποίησης του συμφραζομένου είναι απαραίτητη για την παραγωγή συνεκτικής γλώσσας.
5. Self-Attention: Πώς ένα μοντέλο συσχετίζει τις λέξεις
Ο μηχανισμός Self-Attention βρίσκεται στον πυρήνα της αρχιτεκτονικής Transformer.
Ας εξετάσουμε την πρόταση:
«Η Μαρία αγόρασε ένα βιβλίο επειδή ήθελε να το διαβάσει».
Για να σχηματίσει μια κατάλληλη αναπαράσταση της αντωνυμίας «το», ένα μοντέλο πρέπει να αξιοποιήσει τη σχέση της με τη λέξη «βιβλίο».
Το Self-Attention επιτρέπει σε διαφορετικές θέσεις της ακολουθίας να συσχετίζουν τις πληροφορίες τους.
Στη βασική μαθηματική του μορφή χρησιμοποιεί τρεις κατηγορίες διανυσμάτων:
- Query (Q): την πληροφορία που αναζητά μια θέση.
- Key (K): την πληροφορία με την οποία μπορεί να συγκριθεί.
- Value (V): την πληροφορία που συνεισφέρει στο αποτέλεσμα.
Ο κλασικός τύπος είναι:
Attention(Q, K, V) = softmax(QKᵀ / √dₖ) V
Το γινόμενο QKᵀ παράγει βαθμολογίες συσχέτισης.
Η διαίρεση με την τετραγωνική ρίζα της διάστασης των Keys βοηθά στη διατήρηση μιας κατάλληλης αριθμητικής κλίμακας.
Η συνάρτηση softmax μετατρέπει τις βαθμολογίες σε βάρη.
Τέλος, τα βάρη χρησιμοποιούνται για να συνδυαστούν τα διανύσματα Value.
Στην πράξη, τα μοντέλα μπορούν να χρησιμοποιούν πολλαπλές κεφαλές προσοχής (Multi-Head Attention), που επεξεργάζονται διαφορετικούς τύπους συσχετίσεων.
Στα αυτοπαλινδρομικά GPT μοντέλα εφαρμόζεται επίσης ένας αιτιακός περιορισμός: κάθε θέση μπορεί να αξιοποιήσει πληροφορίες από τις προηγούμενες θέσεις και από την ίδια, όχι όμως από μελλοντικά tokens που δεν έχουν παραχθεί.
Πρέπει να σημειωθεί ότι τα βάρη Attention δεν αποτελούν από μόνα τους μια πλήρη, ανθρώπινα κατανοητή εξήγηση του τρόπου λήψης αποφάσεων του μοντέλου.
6. Τι συμβαίνει μέσα στα επίπεδα του Transformer;
Ένας Transformer αποτελείται από διαδοχικά υπολογιστικά επίπεδα.
Στη συνήθη αρχιτεκτονική, αυτά περιλαμβάνουν μηχανισμούς Attention, νευρωνικά δίκτυα Feed-Forward, συνδέσεις υπολοίπου (Residual Connections) και διαδικασίες κανονικοποίησης.
Ένα Feed-Forward Network εφαρμόζει μαθηματικούς μετασχηματισμούς στις εσωτερικές αναπαραστάσεις.
Μια απλή μορφή του περιγράφεται από την εξίσωση:
FFN(x) = W₂ σ(W₁x + b₁) + b₂
Τα W αντιπροσωπεύουν πίνακες βαρών, τα b παραμέτρους μετατόπισης και το σ μια μη γραμμική συνάρτηση ενεργοποίησης.
Η μη γραμμικότητα επιτρέπει στο δίκτυο να αναπαριστά πολύπλοκες σχέσεις.
Καθώς οι πληροφορίες περνούν από διαδοχικά επίπεδα, οι εσωτερικές τους αναπαραστάσεις αλλάζουν.
Αυτό που ξεκίνησε ως μια ακολουθία αριθμητικών κωδικών μετατρέπεται σε ένα σύνθετο σύνολο αναπαραστάσεων, το οποίο μπορεί να υποστηρίξει την παραγωγή μιας απάντησης.
Ο ακριβής αριθμός επιπέδων, παραμέτρων και εσωτερικών διαστάσεων δεν είναι απαραίτητα δημόσια γνωστός για κάθε εμπορικό μοντέλο.
7. Πώς εκπαιδεύεται ένα σύστημα όπως το ChatGPT;
Η εκπαίδευση μεγάλων γλωσσικών μοντέλων περιλαμβάνει διαφορετικά στάδια.
Προεκπαίδευση (Pre-training)
Στην προεκπαίδευση, το μοντέλο μαθαίνει να προβλέπει την πιθανή συνέχεια μιας ακολουθίας.
Αρχικά οι προβλέψεις του είναι ανεπαρκείς.
Σταδιακά, μέσα από επαναλαμβανόμενους υπολογισμούς, οι παράμετροι προσαρμόζονται ώστε να μειώνεται το σφάλμα πρόβλεψης.
Μία συνηθισμένη συνάρτηση απώλειας είναι η αρνητική λογαριθμική πιθανότητα των πραγματικών tokens:
L = −Σ log P(xₜ | x₁, …, xₜ₋₁)
Η εκπαίδευση χρησιμοποιεί τεχνικές όπως η οπισθοδιάδοση του σφάλματος (backpropagation) και η βελτιστοποίηση παραμέτρων.
Με αυτόν τον τρόπο, το σύστημα μαθαίνει στατιστικά και δομικά χαρακτηριστικά της γλώσσας και των πληροφοριών που περιλαμβάνονται στα δεδομένα.
Μετεκπαίδευση (Post-training)
Ένα μοντέλο που απλώς προβλέπει την επόμενη λέξη δεν είναι απαραίτητα και ένας χρήσιμος ψηφιακός βοηθός.
Γι’ αυτό εφαρμόζονται πρόσθετες τεχνικές εκπαίδευσης.
Σε αυτές περιλαμβάνονται η επιβλεπόμενη προσαρμογή σε παραδείγματα οδηγιών (Supervised Fine-Tuning), καθώς και τεχνικές που αξιοποιούν ανθρώπινες προτιμήσεις ή άλλα σήματα αξιολόγησης.
Μια ιστορικά σημαντική μέθοδος είναι η Reinforcement Learning from Human Feedback (RLHF).
Στην προσέγγιση αυτή, ανθρώπινες αξιολογήσεις διαφορετικών απαντήσεων χρησιμοποιούνται για τη βελτίωση της συμπεριφοράς του μοντέλου.
Η διαδικασία αυτή τεκμηριώθηκε, μεταξύ άλλων, στην έρευνα για το InstructGPT το 2022.
Οι ακριβείς τεχνικές που χρησιμοποιούνται σε κάθε νεότερο μοντέλο μπορεί να διαφέρουν και δεν είναι όλες δημόσια γνωστές.
8. Πώς δημιουργείται μια απάντηση;
Όταν ένας χρήστης υποβάλει μια ερώτηση, το μοντέλο χρησιμοποιεί το διαθέσιμο συμφραζόμενο και τις εκπαιδευμένες παραμέτρους του για να υπολογίσει μια κατανομή πιθανοτήτων για το επόμενο token.
Έπειτα επιλέγεται ένα token και η διαδικασία επαναλαμβάνεται.
Η ακολουθία που έχει ήδη παραχθεί επηρεάζει τις επόμενες επιλογές.
Αυτό ονομάζεται αυτοπαλινδρομική παραγωγή (autoregressive generation).
Ένα απλό παράδειγμα:
Ο χρήστης ρωτά: «Τι είναι η βαρύτητα;»
Το μοντέλο μπορεί να αρχίσει να παράγει:
«Η βαρύτητα είναι…»
Η συνέχεια παράγεται σταδιακά, μέχρι να ολοκληρωθεί η απάντηση.
Η επιλογή των tokens μπορεί να περιλαμβάνει τεχνικές δειγματοληψίας. Δεν χρειάζεται να επιλέγεται πάντα η αριθμητικά πιθανότερη συνέχεια.
Για μεγαλύτερη υπολογιστική απόδοση μπορούν επίσης να χρησιμοποιούνται τεχνικές όπως το KV cache, που επιτρέπουν την επαναχρησιμοποίηση προηγούμενων υπολογισμών κατά την παραγωγή.
9. Πώς μπορεί να κάνει συλλογισμούς ένα σύστημα πρόβλεψης κειμένου;
Εδώ εμφανίζεται ένα από τα σημαντικότερα ερωτήματα της σύγχρονης έρευνας στην Τεχνητή Νοημοσύνη.
Πώς μπορεί ένα σύστημα που εκπαιδεύτηκε αρχικά να προβλέπει tokens να επιλύει μαθηματικά προβλήματα, να γράφει λειτουργικό κώδικα ή να κατασκευάζει επιχειρήματα;
Η απάντηση σχετίζεται με την ικανότητα των μεγάλων νευρωνικών δικτύων να αναπτύσσουν σύνθετες εσωτερικές αναπαραστάσεις και υπολογιστικές διαδικασίες.
Η επεξεργασία γλωσσικών δεδομένων μεγάλης κλίμακας μπορεί να υποστηρίξει τη μάθηση σχέσεων που δεν περιορίζονται στην επιφανειακή σύνταξη.
Επιπλέον, η μετεκπαίδευση, η αξιολόγηση απαντήσεων και η δυνατότητα αφιέρωσης πρόσθετου υπολογισμού σε δύσκολα προβλήματα μπορούν να ενισχύσουν τη συμπεριφορά συλλογισμού.
Αυτό, όμως, δεν σημαίνει ότι κάθε απάντηση αποτελεί μαθηματική απόδειξη ή ότι το σύστημα διαθέτει έναν αλάνθαστο μηχανισμό λογικής.
Ένα γλωσσικό μοντέλο μπορεί να καταλήξει σε λανθασμένο συμπέρασμα, ακόμη και όταν η εξήγησή του φαίνεται πειστική.
10. Γιατί η Τεχνητή Νοημοσύνη κάνει λάθη;
Οι λεγόμενες «παραισθήσεις» (hallucinations) αποτελούν ένα από τα πιο γνωστά προβλήματα των γλωσσικών μοντέλων.
Πρόκειται για περιπτώσεις στις οποίες το μοντέλο παράγει πληροφορίες που ακούγονται αξιόπιστες, αλλά είναι λανθασμένες ή ανυπόστατες.
Αυτό μπορεί να συμβεί επειδή η παραγωγή μιας πιθανής γλωσσικής συνέχειας δεν ισοδυναμεί με την επαλήθευση της πραγματικής αλήθειας.
Η επιστημονική έρευνα έχει επίσης εξετάσει πώς ορισμένες διαδικασίες εκπαίδευσης και αξιολόγησης μπορούν να ενθαρρύνουν την παραγωγή απαντήσεων ακόμη και όταν υπάρχει αβεβαιότητα.
Για τον λόγο αυτό, τα γλωσσικά μοντέλα δεν πρέπει να αντιμετωπίζονται ως αλάνθαστες αυθεντίες.
Ιδιαίτερα σε ζητήματα υγείας, δικαίου, οικονομίας και επιστημονικής τεκμηρίωσης, ο έλεγχος αξιόπιστων πηγών παραμένει απαραίτητος.
11. Έχει μνήμη το ChatGPT;
Χρειάζεται να διακρίνουμε την εκπαίδευση του μοντέλου από τη χρήση του ιστορικού μιας συνομιλίας.
Τα εκπαιδευμένα βάρη περιέχουν τις αριθμητικές δομές που διαμορφώθηκαν κατά την εκπαίδευση.
Το λεγόμενο context window περιλαμβάνει τις πληροφορίες που είναι διαθέσιμες στο μοντέλο κατά την επεξεργασία μιας συγκεκριμένης αλληλεπίδρασης.
Έτσι, ένα σύστημα μπορεί να αξιοποιεί προηγούμενα μηνύματα μιας συζήτησης χωρίς να αλλάζει άμεσα τις εκπαιδευμένες παραμέτρους του.
Ορισμένες εφαρμογές διαθέτουν και ξεχωριστές λειτουργίες μνήμης ή σύνδεσης με αποθηκευμένες πληροφορίες.
Πρόκειται για πρόσθετες λειτουργίες της εφαρμογής και όχι απαραίτητα για αλλαγές στα βάρη του νευρωνικού δικτύου.
12. Πόση υπολογιστική ισχύ χρειάζεται;
Η εκπαίδευση μεγάλων γλωσσικών μοντέλων αποτελεί απαιτητικό υπολογιστικό έργο.
Χρησιμοποιούνται εξειδικευμένοι επιταχυντές, όπως GPUs, και συστήματα παράλληλης επεξεργασίας.
Οι υπολογισμοί περιλαμβάνουν πολλαπλασιασμούς μεγάλων πινάκων, επεξεργασία διανυσμάτων και προσαρμογή τεράστιων συνόλων παραμέτρων.
Η εκπαίδευση είναι διαφορετική από τη διαδικασία παραγωγής απαντήσεων, γνωστή ως inference.
Κατά το inference, το μοντέλο αξιοποιεί τις ήδη εκπαιδευμένες παραμέτρους του για να επεξεργαστεί νέα δεδομένα.
Οι υπολογιστικές απαιτήσεις εξαρτώνται από πολλούς παράγοντες, μεταξύ των οποίων το μέγεθος και η αρχιτεκτονική του μοντέλου, η έκταση του συμφραζομένου και ο αριθμός των tokens που παράγονται.
13. Καταλαβαίνει πραγματικά η Τεχνητή Νοημοσύνη;
Το ερώτημα αυτό βρίσκεται στα όρια της πληροφορικής, της γνωσιακής επιστήμης και της φιλοσοφίας.
Από λειτουργική άποψη, τα σύγχρονα γλωσσικά μοντέλα μπορούν να χρησιμοποιούν έννοιες, να αναγνωρίζουν συσχετίσεις και να επιλύουν ορισμένα σύνθετα προβλήματα.
Αυτό αποτελεί παρατηρήσιμη υπολογιστική συμπεριφορά.
Ωστόσο, η ικανότητα παραγωγής νοηματικά συνεκτικού λόγου δεν αποδεικνύει αυτομάτως την ύπαρξη υποκειμενικής εμπειρίας.
Το αν ένα σύστημα Τεχνητής Νοημοσύνης μπορεί να διαθέτει συνείδηση παραμένει ανοιχτό ερευνητικό και φιλοσοφικό ζήτημα.
Δεν υπάρχει σήμερα καθολικά αποδεκτή επιστημονική μέθοδος που να επιλύει οριστικά αυτό το ερώτημα.
Επομένως, χρειάζεται να διακρίνουμε τι μπορεί να κάνει ένα σύστημα από το τι ενδεχομένως βιώνει.
14. Τι γνωρίζουμε και τι δεν γνωρίζουμε για το GPT-6;
Οι βασικές αρχές των Transformers, της tokenization, των embeddings, της βελτιστοποίησης νευρωνικών δικτύων και της αυτοπαλινδρομικής παραγωγής αποτελούν δημοσίως τεκμηριωμένη τεχνολογία.
Ωστόσο, η πλήρης εσωτερική υλοποίηση ενός συγκεκριμένου εμπορικού μοντέλου δεν είναι απαραίτητα διαθέσιμη στο κοινό.
Για το GPT-6 δεν πρέπει να παρουσιάζονται ως επιβεβαιωμένα τεχνικά χαρακτηριστικά στοιχεία όπως ο ακριβής αριθμός παραμέτρων, η εσωτερική διάρθρωση όλων των επιπέδων ή οι πλήρεις διαδικασίες εκπαίδευσης, χωρίς επίσημη τεκμηρίωση.
Η παρούσα ανάλυση περιγράφει, συνεπώς, τις γνωστές τεχνολογικές αρχές της οικογένειας GPT και όχι μια πλήρη αποτύπωση του ιδιόκτητου σχεδιασμού της συγκεκριμένης έκδοσης.
Συμπέρασμα: Μια νέα μορφή υπολογιστικής νοημοσύνης
Το ChatGPT δεν είναι απλώς μια μηχανή αναζήτησης ούτε μια συλλογή προκατασκευασμένων απαντήσεων.
Είναι μέρος μιας τεχνολογικής εξέλιξης που συνδυάζει νευρωνικά δίκτυα, μαθηματική βελτιστοποίηση, μεγάλα σύνολα δεδομένων και ιδιαίτερα ισχυρή υπολογιστική υποδομή.
Η βασική αρχή της πρόβλεψης του επόμενου token, σε συνδυασμό με τις σύγχρονες αρχιτεκτονικές και τις μεθόδους εκπαίδευσης, μπορεί να οδηγήσει σε εντυπωσιακές ικανότητες γλωσσικής επεξεργασίας και επίλυσης προβλημάτων.
Παρά τις δυνατότητές τους, αυτά τα συστήματα έχουν πραγματικούς περιορισμούς. Η αξιοπιστία τους πρέπει να αξιολογείται, οι απαντήσεις τους να ελέγχονται και οι δυνατότητές τους να μην συγχέονται με βεβαιότητες για τη φύση της ανθρώπινης σκέψης.
Ίσως, τελικά, το σημαντικότερο ερώτημα να μην είναι μόνο πώς μια μηχανή μπορεί να παράγει λόγο που μοιάζει ανθρώπινος.
Είναι επίσης τι μας αποκαλύπτει αυτή η τεχνολογία για την ίδια τη γλώσσα, τη γνώση και τη νοημοσύνη.
Επιστημονικές πηγές και περαιτέρω ανάγνωση
- Vaswani, A. et al. (2017). Attention Is All You Need.
https://arxiv.org/abs/1706.03762 - Ouyang, L. et al. (2022). Training Language Models to Follow Instructions with Human Feedback.
https://arxiv.org/abs/2203.02155 - OpenAI. How ChatGPT and Our Foundation Models Are Developed.
https://help.openai.com/en/articles/7842364-how-chatgpt-and-our-foundation-models-are-developed - OpenAI (2025). Why Language Models Hallucinate.
https://openai.com/index/why-language-models-hallucinate/
Συντακτική σημείωση — FreeThinking.gr
Το παρόν άρθρο δημιουργήθηκε με τη συνδρομή του ChatGPT της OpenAI, με στόχο την εκλαϊκευμένη παρουσίαση της τεχνολογίας των μεγάλων γλωσσικών μοντέλων. Οι εξηγήσεις βασίζονται σε δημοσίως διαθέσιμες επιστημονικές εργασίες και τεχνικές πληροφορίες. Οι αναφορές στην αρχιτεκτονική των Transformers δεν πρέπει να εκλαμβάνονται ως αποκάλυψη μη δημοσιευμένων τεχνικών χαρακτηριστικών του GPT-6.